GDB 最有价值的地方,不是把 printf 换成 print,而是把一个很大的问题缩成一个可以验证的命题:哪次输入第一次违反约束?谁最后写坏了这个状态?当前线程到底在等谁?崩溃现场和我手里的源码是不是同一个版本?
这次在原笔记上补成一条实战路线:先建立调试现场,再用条件断点和观察点找原因,接着处理异常、多线程和离线 core,最后把重复分析做成脚本,并迁移到 ROS 2 工程。
本文保留原文章地址和历史章节锚点。侧边目录就是导航,不再放一份手写目录占据正文。
先看实验与边界
示例程序故意包含几个彼此独立的小问题,避免直接在几万行机器人代码里练习所有命令:
| 模式 | 要回答的问题 | 关键工具 |
|---|---|---|
conditional |
六次输出中,哪一次符号反了? | 条件断点、参数、调用栈 |
watchpoint |
余额在何处被写成了错误值? | 硬件观察点、写入位置 |
threads |
工作线程为什么都不再推进? | 所有线程栈、等待条件 |
exception |
异常被上层吞掉之前在哪里抛出? | catch throw、up |
core |
进程不在了,还能看到什么? | core、符号、源码映射 |
| Python 过滤 | 能否让断点自动筛出异常状态? | GDB Python API |
reverse |
能否回到前一次整数写入? | record full、反向单步 |
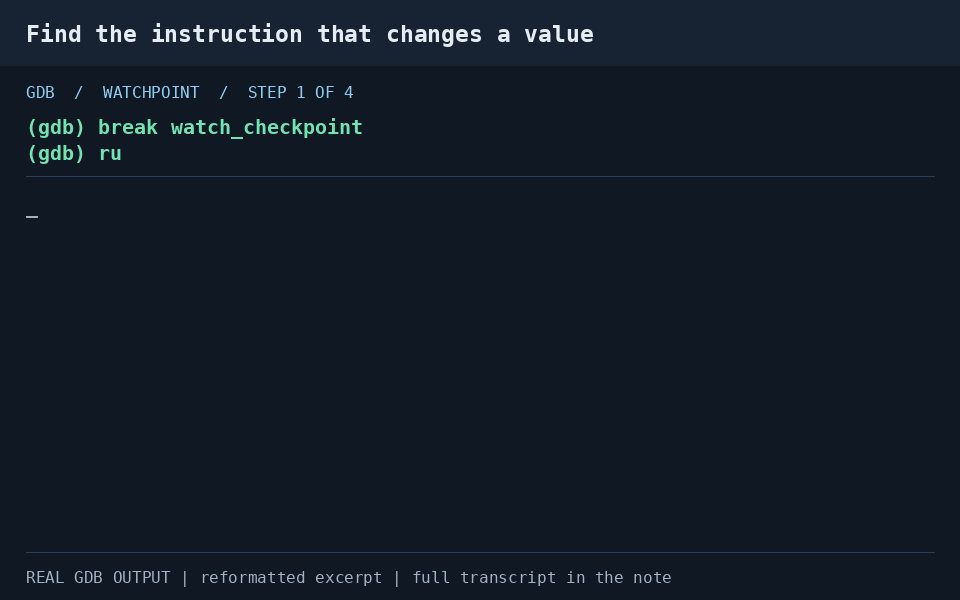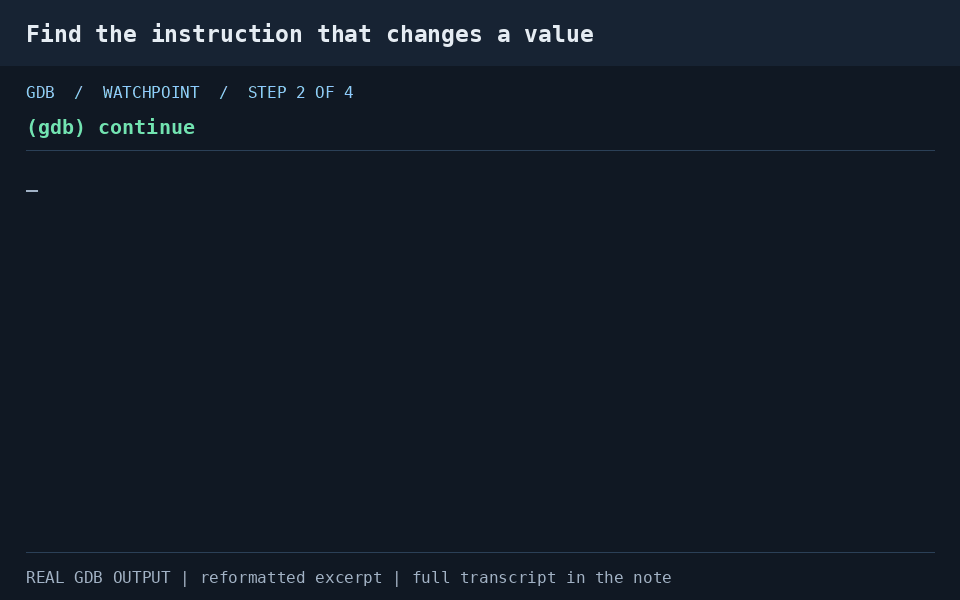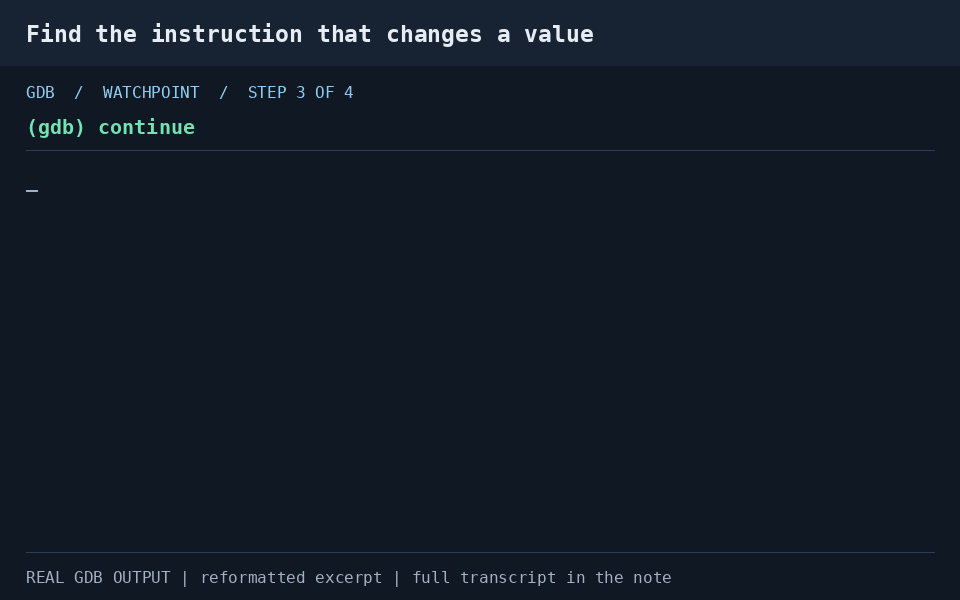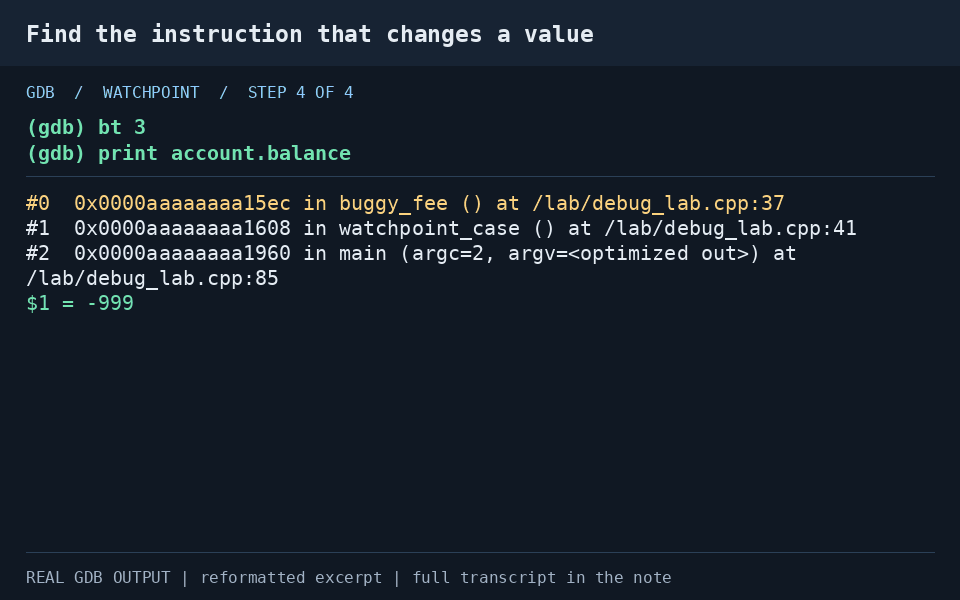
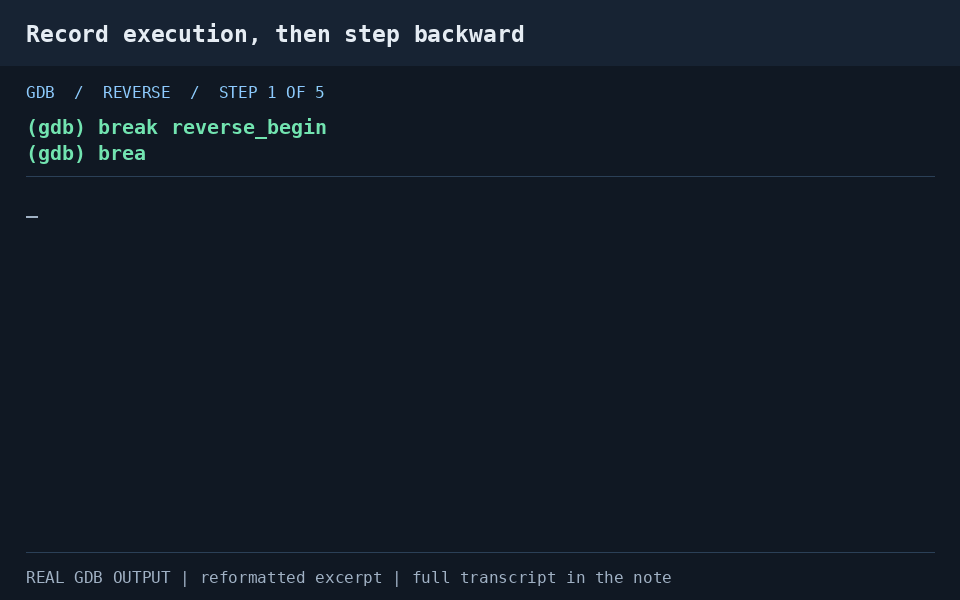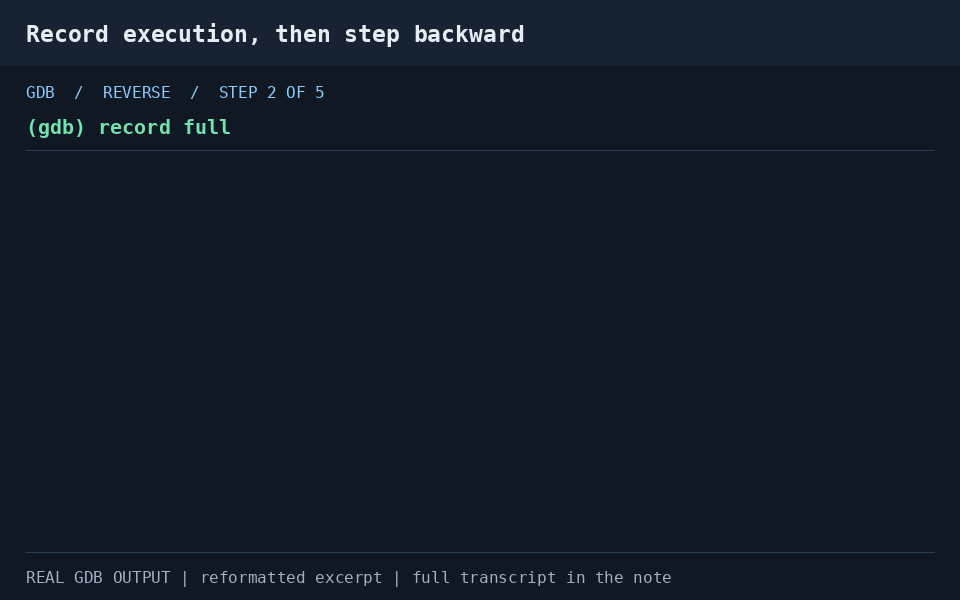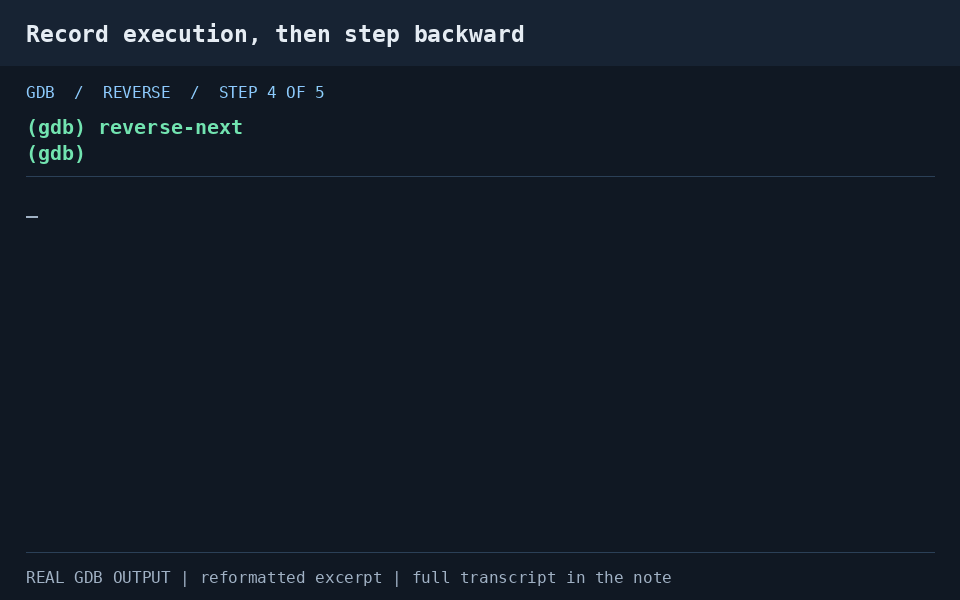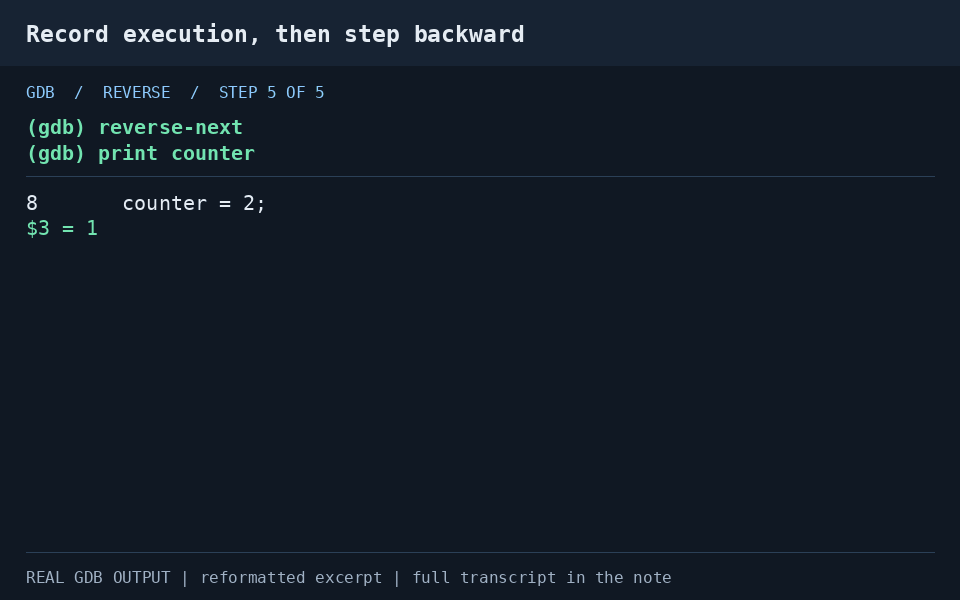
操作动画来自实验命令的真实输出,经过取舍、分帧和排版,属于教学动画,不是桌面录屏。地址、进程号和线程号会随运行变化,不应该拿 GIF 中的地址作为自己的命令参数。静态说明包含同样的关键结论;系统开启减少动态效果时显示静态图片。
实验材料:源码、复现说明、会话记录、验证状态。判断某项是否在当前机器上跑通,以验证状态和原始记录为准。文中的远程调试、ROS 2、rr、Sanitizer 等工程扩展不是这几个小实验的测试覆盖范围。
本次记录环境为 ARM64 / Ubuntu 22.04 / GDB 12.1,上述七组实验的 18 项断言通过。这个结论只覆盖随文程序与记录中的命令,不等于所有高级功能、其他架构或所有实际工程都已测试。
使用隔离环境
在网站源码仓库根目录执行:
bash docker/gdb-lab/run.sh build |
前两步构建 Ubuntu 22.04 实验镜像并执行检查;第三步进入交互容器。源码只读挂载到 /lab,临时可执行文件放在 /work,测试输出保存在宿主机的 build/gdb-lab/。
进入交互容器后,先编译本文的主实验:
g++ -std=c++17 -g3 -Og -fno-omit-frame-pointer \ |
每个实验建议重新启动一个 GDB 会话,避免上个实验的断点、观察点和参数残留。--nx 不加载个人初始化文件,使复现不依赖某个人的 .gdbinit:
gdb --quiet --nx --args /work/debug_lab conditional |
容器为 ptrace 调试显式放开了相应权限,但无网络、无宿主 PID 共享、无 Docker socket 挂载。这里的权限组合是临时教学环境的选择,不要直接复制到生产服务。实验程序会故意挂起、抛异常或触发空指针崩溃,只在隔离容器内运行。
符号与现场
为什么已经有源码,还需要 -g
CPU 执行的是机器指令,不知道哪一行是 controller.update()。调试信息把指令地址关联回源文件、行号、类型、变量位置等信息。它不是把源码解释执行,也不是一个“所有变量永远可见”的保证。
三个常用构建目标要分开:
# 本文实验:保留调试信息,同时进行适合调试的优化 |
-g3 比通常的 -g 多保留宏等信息;-Og 面向编辑—编译—调试循环。GCC 明确建议在没有其他优化选项时考虑 -Og 配合 -g,不能简单认定 -O0 在所有方面都更适合调试。GCC 调试选项
对于实验,-O0 很适合减少初学者看到的行号跳跃;对于只在发布构建出现的问题,应该保留出问题的优化条件。把 -O2 改成 -O0 后问题消失,只说明复现条件改变了,不等于找到了原因。
看到 <optimized out> 时,可能是变量已经被消除、合并,或者在当前位置没有可用的位置描述。看到“下一步跳过了某行”,可能是多行共享指令、内联或重排。先记录编译参数,再看 disassemble /s,不要立即归因于 GDB 出错。
先确认调试的是哪一个文件
show version |
一个常见错位是:修改了 build/ 里的程序,却启动了 install/ 里另一份程序;或者可执行文件正确,但加载了旧版本共享库。源码窗口出现熟悉的文件名,并不能证明二进制和源码一致。
在容器或 CI 中,还应记录编译器、GDB、标准库、目标架构、构建提交和实际编译命令。本文实验把这些信息写入实验产物,后续迁移时优先比较这些事实,而不是只比较“都是 Ubuntu 22.04”。
建立最小操作闭环
start |
start 启动并在 main 附近停住;next 推进当前栈帧的一行,step 尝试进入可调试的被调用函数,finish 运行到当前函数返回,continue 则继续到下一个停止事件。这些都是“运行程序”,不是静态浏览代码。GDB 继续与单步
在当前停止状态下,源代码高亮行通常指即将执行的语句。观察赋值结果时,先确认该语句有没有执行,必要时再 next 一次。
特别注意:frame 是改变观察视角,next 才会推进执行;两者不是同一类操作。在并发程序里,next 也不等于“整个进程只有这一行发生变化”,后面的线程章节会解释。
只停在异常那一次
实验:找出反号输出
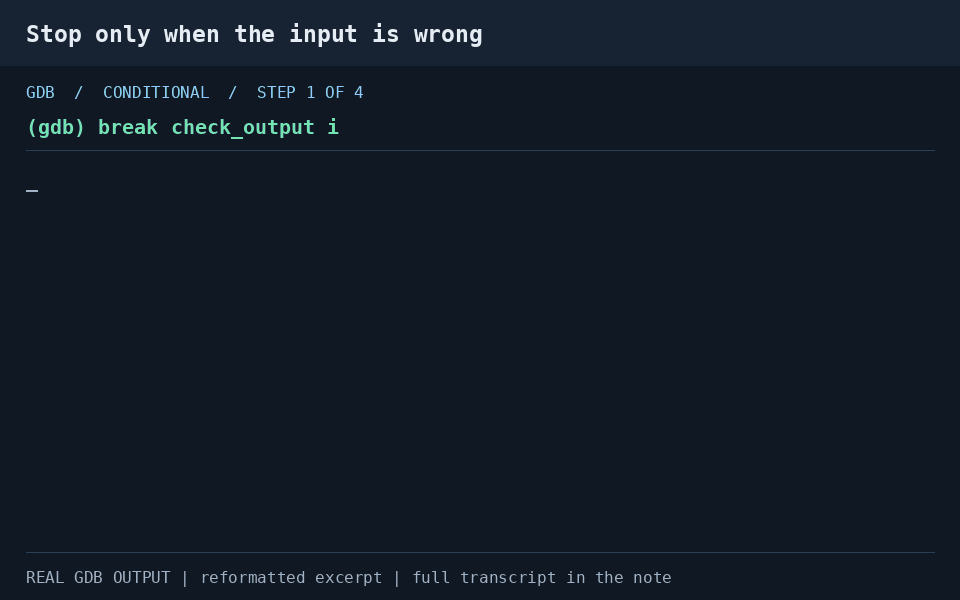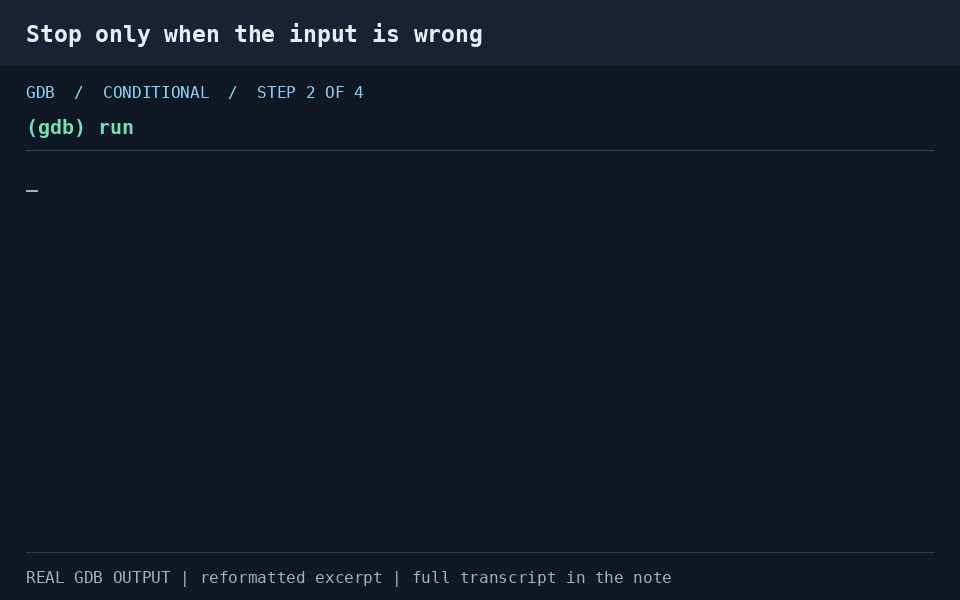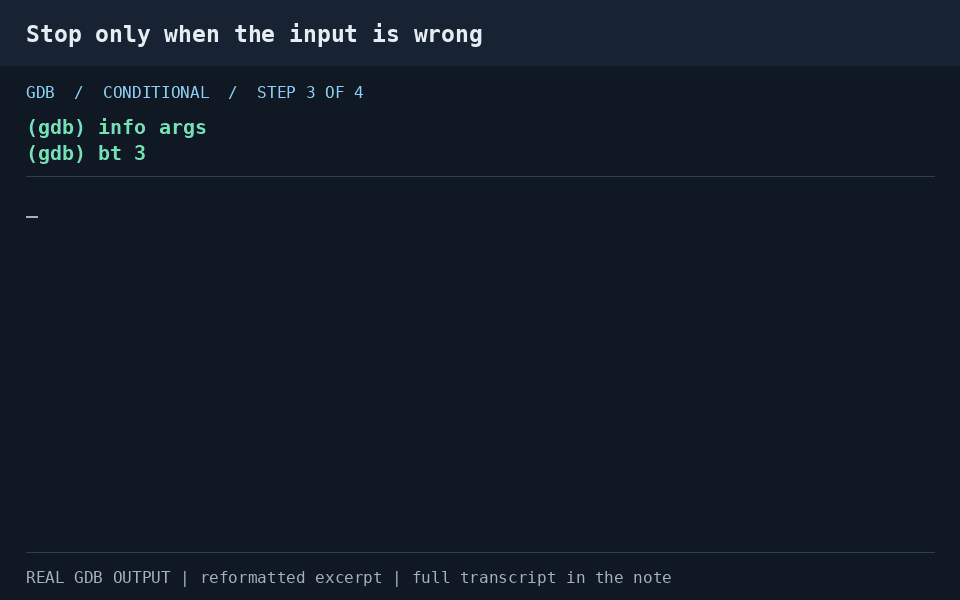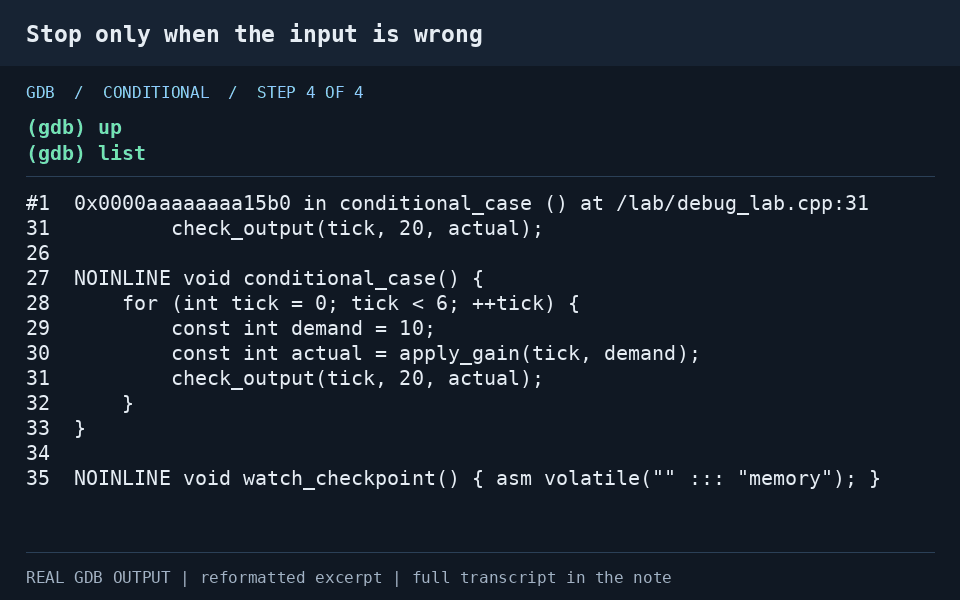
程序在六次循环中都向 check_output(tick, expected, actual) 传入结果,但只有一次实际值与期望值不一致。先不要逐行跟六遍循环,直接把业务约束写成断点条件:
gdb --quiet --nx --args /work/debug_lab conditional |
break check_output if actual != expected |

观察重点是 tick、expected、actual 三个参数,而不是断点编号。示例在 tick == 3 时反转输出符号,因此应检查到期望值 20 与实际值 -20 的差异;随后顺着调用方回看 apply_gain 的输入和分支。这是“先定位违反约束的时刻,再向上找原因”的流程。
条件表达式必须在断点位置可见。在 main 上写 actual < 0 没有意义,因为这个局部参数不属于 main 的作用域。表达式最好只读取简单状态,避免在条件里调用有副作用、可能加锁的业务函数。GDB 条件断点
将断点变成有策略的探针
下面是独立的用法,不需要全部叠加到同一个会话;示例中的断点编号 1 以 info breakpoints 实际输出为准:
info breakpoints |
condition 1 不带表达式会清掉条件。ignore 1 100 是忽略接下来的 100 次命中,不是“第 100 帧才命中”;有 ignore 计数时,条件不会像平常一样逐次判断。程序重启、调用频率变化之后,次数也未必对应同一个业务时刻。
一次性停车点、函数族和晚加载插件则适合下面这些策略:
tbreak check_output |
tbreak 命中一次后自动删除;rbreak 用正则匹配函数名,可能创建很多断点;pending 断点允许符号暂未加载,适合 dlopen、pluginlib 等场景,但函数名写错也可能一直 pending。因此插件加载后必须再次检查解析状态,而不是把 <PENDING> 当成已成功。GDB 设置断点
rbreak 不会像 pending 单个断点那样自动代表所有未来才出现的函数集合。模板、重载和内联函数还可能对应多个位置,要用 info breakpoints 看清最终设置在哪里。
不重新编译,临时补日志
在一个新的 conditional 会话中,设置断点后立即定义命令列表:
break check_output |
commands 不写编号时针对最后创建的断点。silent 必须在命令列表开头;continue 会恢复程序,因此放在它后面的列表命令不会按直觉继续执行。这个例子会自动记录每次输出,再自动放行。GDB 断点命令列表
只需要一条格式化日志时,可用更短的动态打印:
set dprintf-style gdb |
这里显式选用由 GDB 打印的模式。dprintf 不是免费的在线埋点:它仍可能通过断点与调试器往返影响运行时序,尤其是远程、高频控制循环。其他打印模式和目标端代理支持也有额外条件,不能把这个命令等同于无暂停 tracing。GDB Dynamic Printf
找到谁写坏了状态
实验:余额为什么突然变负
watchpoint 模式先把余额从 100 加到 125,随后某个函数错误地写入 -999。这里故意使用合法地址上的错误业务写入,不是依赖未定义行为的数组越界。
gdb --quiet --nx --args /work/debug_lab watchpoint |
break watch_checkpoint |

第一次变化是正常入账,第二次变化才是要追踪的错误。观察点的关键价值在于:先知道“哪个状态坏了”,不必先猜“哪个函数写坏了它”。停住之后再看写入附近的指令、源码和调用栈,错误写入路径就具体了。
三种观察点不能混为一谈
watch account.balance |
watch 关心写入后表达式的值变化;rwatch 关心读取;awatch 关心读或写。写入相同数值通常不会表现成 watch 所关心的值变化。后两种需要目标支持硬件观察点,不能假设软件回退能模拟它们。GDB 观察点
地址与生命周期才是难点
假设当前函数里有 State* state,并且已经确认它指向有效对象,可以这样固定要看的内存位置:
print state |
这里的 $watched 是 GDB 的便利变量,不是给程序新增的 C++ 变量。watch state 看的是指针本身;watch *state 看的是它指向的对象;watch -location state->mode 则固定当前求值所得字段地址。三个问题并不相同。
固定地址不代表延长对象寿命。对象销毁、vector 扩容、内存池复用后,那个地址可能已属于另一个对象;局部变量离开作用域也可能让普通表达式观察点失效。再次 run 后还要重新建立依赖局部对象的观察点。
硬件观察点的数量、可覆盖宽度和对齐约束依目标而异。一个大结构体可能需要多个硬件资源;软件观察点通过频繁单步比较值,代价很大,对多线程也有明显限制。如果继续运行时报无法插入观察点,先缩小范围和数量,不要直接开启更宽的权限。
对于机器人状态,优先盯住真正的异常字段,例如 mode、sequence、valid 或某个元素,通常比盯住整个大型矩阵更有用。观察点回答“哪次写入”,但不会自动证明这次写入在业务上不该发生;这个判断仍来自你的约束。
读懂栈和对象
栈帧是观察上下文
bt |
#0 是当前执行位置,#1 是它的调用者,编号向更外层增加。崩溃发生在 memcpy 或标准库内部,不意味着标准库就是根因;应继续看业务调用者传入了什么参数。GDB Backtrace
切换到 frame 2 后,info locals 和 print 按第 2 帧的作用域解释名字;它不会把程序退回到两次函数调用之前。同名的 state 在不同栈帧里可能是不同对象。
调用栈也不是执行历史:已经返回的函数通常不在栈上。看到的只有当前仍未返回的调用链,要追踪先前的写入需要观察点、日志或事先开启的记录回放。
从语义对象到原始字节
print account |
print 按类型解释对象;ptype /o 帮助查看布局和偏移;x 直接查看内存。x/4xb 表示四个字节、十六进制,x/1dw 表示一个 word、十进制。这里 GDB 的 w 是四字节单位,不是“当前 CPU 字长”。GDB 检查内存
对于已确认有效的数组指针 samples,print *samples@8 可查看连续八个元素;但不能因此证明分配了八个元素。类型转换只影响调试器如何解释地址,不会修复无效指针。
遇到看似合理、实际上很异常的浮点值,还要核对单位、坐标系、更新时间和数组尺寸。GDB 能告诉你“这里是 57.3”,不会自动告诉你本该使用弧度还是角度。
STL 和 Eigen 不必一直看内部指针
set print pretty on |
发行版的 libstdc++ 调试支持通常包含 Python pretty-printer,可以把 std::vector、std::map 等内部布局转换为可读内容。先检查是否已经加载,再决定是否配置匹配当前标准库版本的打印器,不要从不同 GCC 版本随意复制一份。libstdc++ 调试支持
Eigen、自定义消息和业务状态也可使用适配其版本的 pretty-printer;未加载时,先看 ptype、维度和实际数据布局,别默认所有矩阵都行主序。打印器是可执行的 Python 扩展,不是纯显示配置。
如果 GDB 因安全路径拒绝自动加载脚本,应审查脚本并只信任所需目录。不要为图省事设置“整个文件系统都是安全路径”。GDB 自动加载安全路径
临时修改用于验证假设
set variable account.balance = 125 |
set variable 能临时改变被调试程序的状态,适合验证“如果这个字段正常,后续路径会不会恢复”。它不修改源码,也不能代替修复和回归测试;还可能绕过对象不变量和同步机制。
类似 print object.refresh() 的表达式可能真的调用目标函数,引起 I/O、分配、加锁甚至异常。看起来是在“打印”,实际上已经干预现场。优先读取字段;确需调用时,明确其副作用,特别不要在死锁现场随意调用需要锁的方法。GDB 调用程序函数
在异常被吞掉前停住
实验:向负时长追溯
exception 模式向 parse_duration 传入负数;函数抛出异常,上层却捕获后什么也不做。只观察进程退出码或最后一行日志,很容易错过真正的错误入口。
gdb --quiet --nx --args /work/debug_lab exception |
catch throw |

通常会先停在异常运行库中,再通过 bt 找业务帧、用 up 或 frame 切换。不要机械记住业务函数永远是 frame 1,不同编译器和库版本可能有不同的中间层。
catch throw 关心“开始抛出”,catch catch 关心“被捕获”,catch rethrow 关心“重新抛出”。异常类型正则过滤和 $_exception 依赖 C++ ABI 及运行库探针支持,且异常便利变量有效期有限,不宜当成各平台通用接口。GDB Catchpoints
在实际工程中,有些异常是正常控制流程。第一次用 catch throw 可以建立全貌,随后应按类型、业务入口或断点条件缩小范围,避免把每次异常都认成崩溃。
崩溃信号则是另一类停止原因:SIGSEGV、SIGABRT 与 C++ throw 不能混为一谈。不要为了让程序“继续跑”就把真正的错误信号全部设成忽略。
线程为什么不再推进
实验:检查工作线程的等待条件
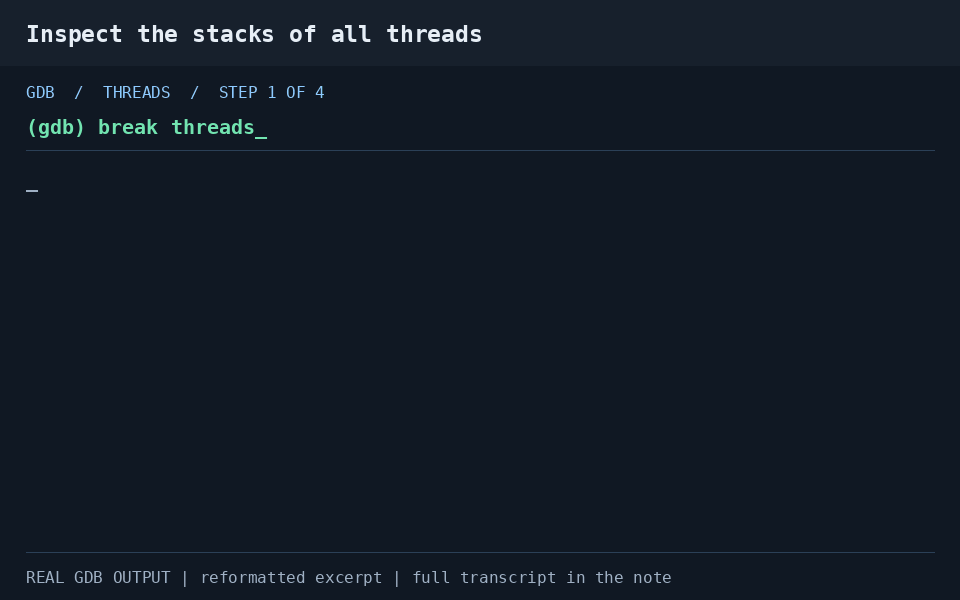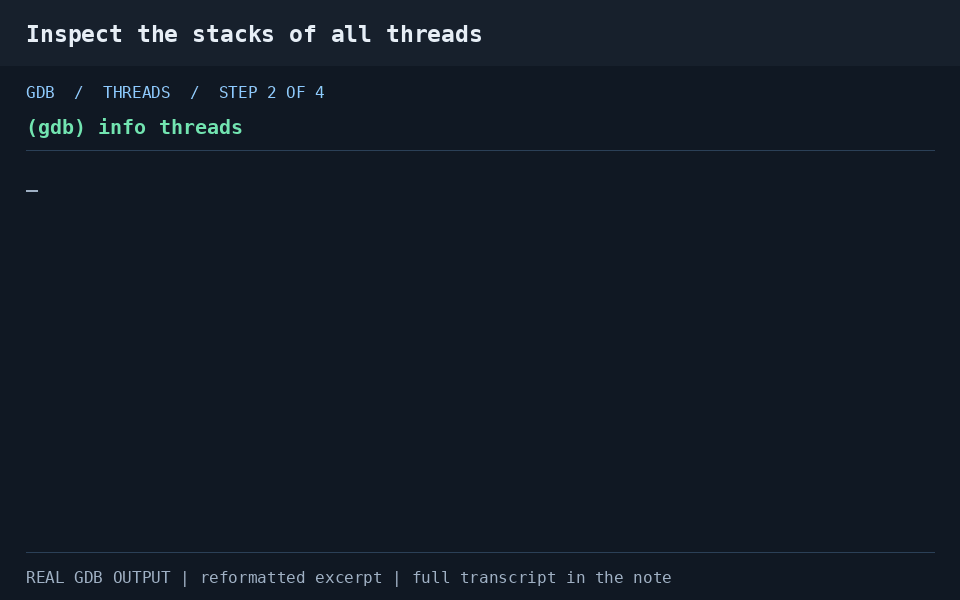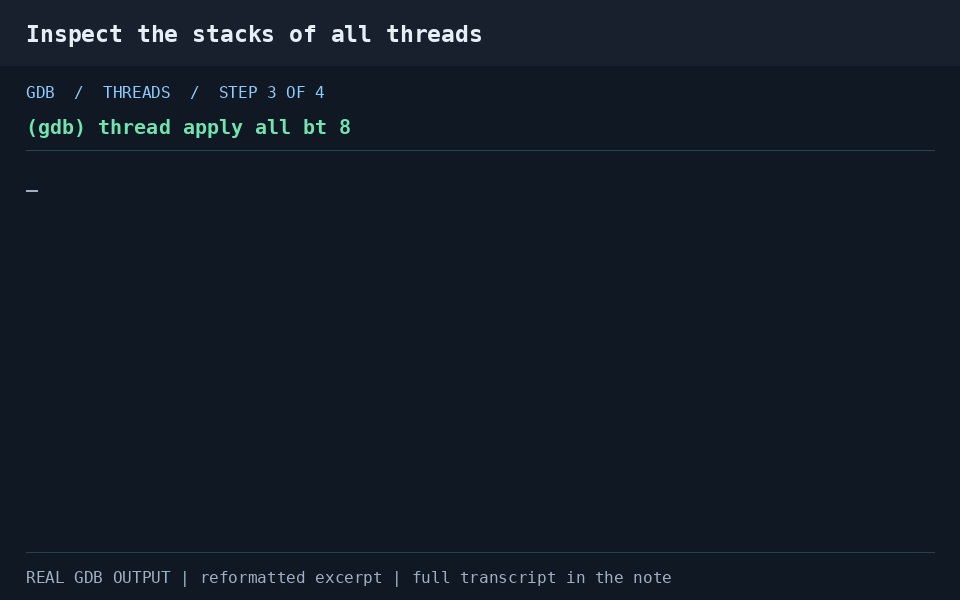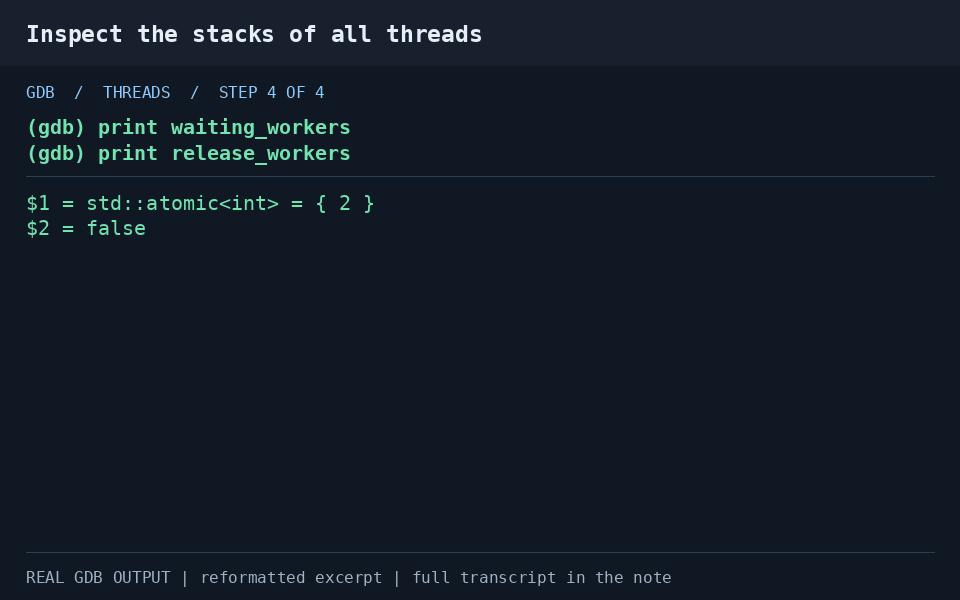
线程实验启动两个 worker,让它们等待同一个条件变量,但故意不发布能够满足条件的工作。为了得到稳定现场,主线程在专用检查点停住。
gdb --quiet --nx --args /work/debug_lab threads |
break threads_checkpoint |

这里应观察到 worker 已进入等待路径,而 release_workers 仍为假。这证明了等待状态,不是证明了互斥锁顺序死锁。 源码中既没有将条件改为真,也没有对应通知,所以恢复执行后主线程会等待 worker 结束。
不能仅凭两个栈中都有 futex 就断言死锁。正常的线程池、DDS 收发线程、定时器线程也会等待。更有用的问题是:谁负责改变等待条件?是否仍有能推进它的线程或外部事件?GDB 线程检查
真正的死锁要建立等待关系
接近死锁的证据链应像这样:线程 A 已持有锁 L1,正在等 L2;线程 B 已持有 L2,正在等 L1。只有“都停在 lock”不够,还要结合锁所有权、调用路径、业务状态确认形成了循环等待。
实际排查可先手动中断进程,再抓一个简洁的全线程快照:
set pagination off |
其中线程号和栈帧号只是操作示意,必须替换成当前现场。thread 2 选择的是 GDB 显示的线程 ID,不要把 Linux 的 TID、PID 和 GDB 编号混用。
若每次中断都停在不同计算行,程序可能只是慢;若长时间重复同一等待链,才更支持“无法推进”的假设。即使如此,也要排除正在等待外部设备、网络输入或人为暂停的情况。
scheduler-locking 会改变你观察的问题
show scheduler-locking |
默认的 all-stop 调试中,停止事件会暂停所有线程,但继续执行和普通单步时,其他线程通常也能运行。scheduler-locking step 在单步阶段限制其他线程,普通 continue 等操作则不按 on 的方式锁住它们;on 会在恢复时只允许运行当前线程。GDB All-Stop 模式
如果当前线程正在等待另一个被你冻结的线程,on 就能人为制造一个“调试器里的死锁”。所以不要把 scheduler-locking 永久写入通用配置;缩小单步范围后及时恢复,并记录修改过的调试状态。
控制程序还有额外风险:你暂停一个进程时,设备、其他进程和外部时钟未必暂停。机器人实机上可能触发心跳超时、看门狗或安全停机。优先在仿真、离线数据和断开动力的环境中练习,不能把“GDB 能暂停”当成“系统可安全暂停”。
进程没了,读 core
实验:保存并重开崩溃现场
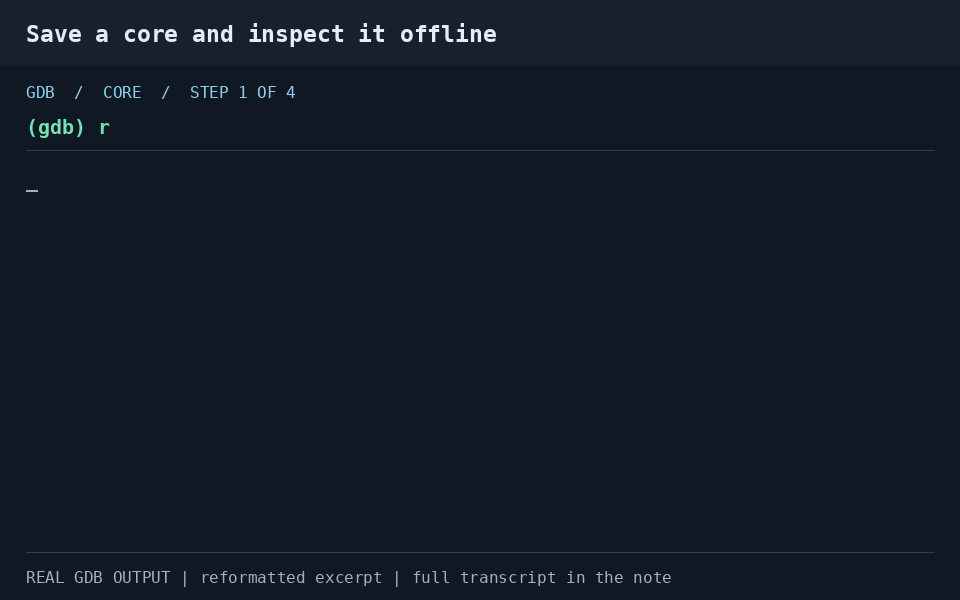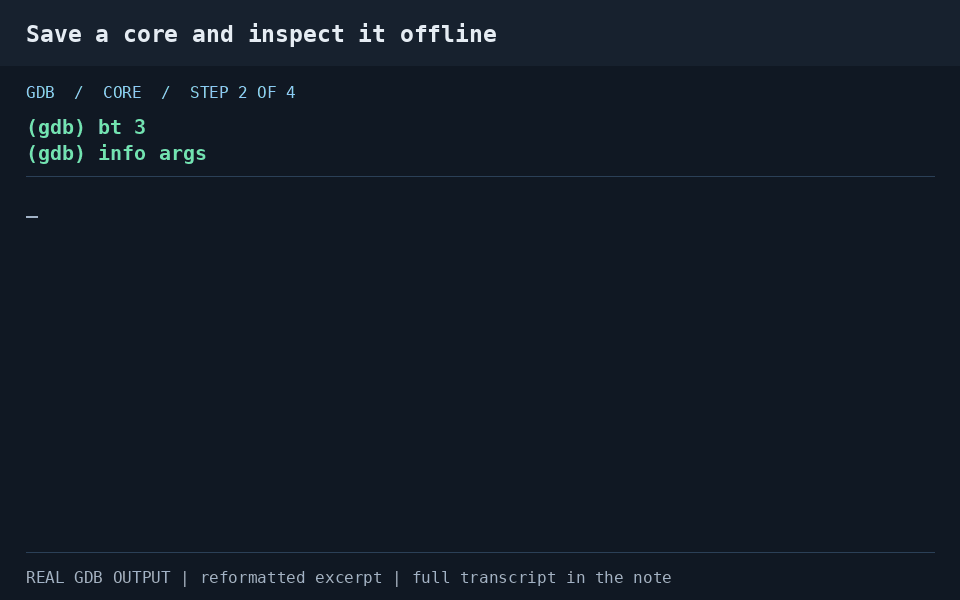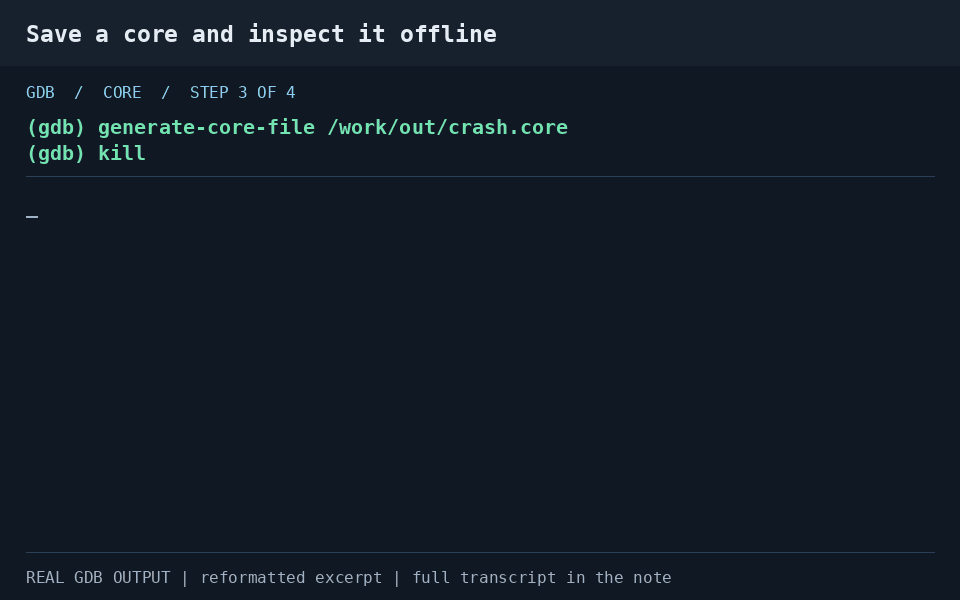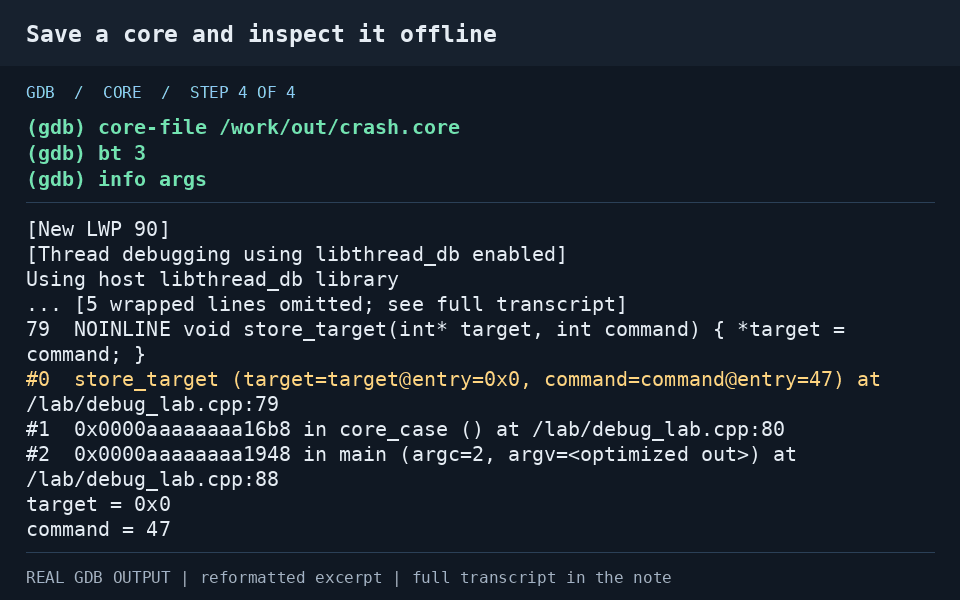
core 模式故意把空指针传给写入函数。下面让程序在 GDB 下触发错误,再由 GDB 主动保存 core,避免依赖宿主系统的 core 收集策略。
gdb --quiet --nx --args /work/debug_lab core |
run |
kill 只针对这个故意崩溃的实验进程;交互模式下按提示确认。生成文件名若已存在,先另取一个名字保留旧现场,不要把生产 core 当临时缓存覆盖。

core 是某个时刻的内存与寄存器等现场,不是时间录像。重开后可以检查已保存的状态,但不能把一个普通 core 当成活进程 continue,也不能从中凭空恢复过去的所有写入。
上面的手动命令是在同一个交互会话中重新加载。自动实验 test 还会将匹配的原始可执行文件一起保存为 build/gdb-lab/debug_lab,因此退出临时容器后,可以重新进入 shell 再打开这对产物:
# 仓库根目录,宿主机执行 |
/work/debug_lab 属于临时文件系统,退出容器即消失;/work/out 是持久输出挂载。若你另外手工编译并生成了新 core,也要保存那次编译的原始二进制,不能混用自动实验遗留的另一份 ELF。源码、动态库与调试符号也要匹配;核心产物只保存在本地,不随网页发布。
复制同一 ELF 回原路径还能避免“找不到 /work/debug_lab 文件映射”的警告。直接指定持久目录中的同一 ELF 也已实测能读回参数,但这不代表可以忽略任意二进制或共享库不匹配警告。完整实测输出另有纯文本日志,不必从 GIF 中抄读。
在有 systemd-coredump 的系统上,另有 coredumpctl 工作流;没有生成 core 时,要检查进程资源限制、收集服务和 core_pattern,不要假设文件一定在当前目录。本文只验证 GDB 主动生成的实验路径。GDB 文件与 core
二进制、符号和共享库要同一次构建
“同一个分支”“同样的版本字符串”不足以保证地址对应。最可靠的交付是:保存出问题的可执行文件、对应的独立调试符号、运行时共享库或镜像标识,以及构建提交与参数。
下面是对实验可执行文件制作发布副本的示例,不对原二进制执行裁剪:
cp /work/debug_lab /work/debug_lab.release |
独立调试文件可通过 debug link 或 build ID 关联到相应二进制。build ID 是匹配构建产物的依据之一,不是拿另一份重新编译结果“强行对号入座”的开关。GDB 独立调试信息
gdb /work/debug_lab.release /work/out/crash.core |
如果 GDB 报 core 与可执行文件不匹配,先处理这个问题。用错符号可能仍能打印出看似合理的函数名,比完全没有符号更容易误导。
迁移路径:substitute-path 不等于 sysroot
假设构建时源码在 /ci/ws/src,现在同一份源码放在 /workspace/src:
set substitute-path /ci/ws/src /workspace/src |
这只改变源码查找路径,不重新编译,也不修复源码版本不一致。若仍显示错误行,检查是否真的是对应提交,而不仅是目录结构一样。GDB 源码路径
目标机器的运行库根目录则是另一件事:
set sysroot /opt/target-rootfs |
sysroot 用于定位目标库文件,debug-file-directory 用于独立调试信息。跨机器分析时,不应该随手用分析机自己的 libc 替代目标机器的 libc;栈展开、类型和符号可能因此不一致。
core 往往包含口令、令牌、图像、网络缓冲区等内存数据。它是敏感产物,不应直接提交到笔记仓库。本文提供的是无敏感输入的教学日志,不发布整份 core。
远程与容器调试
先把调试端口当成控制入口
GDB 连接不是只读监控。调试器可以控制被调试程序、读写其内存,所以 gdbserver 不能暴露给不可信网络。
更稳妥的远程示例是通过 SSH 的标准输入输出连接,不额外开放调试 TCP 端口。在本地加载与目标架构相容的 GDB,以及对应符号文件:
gdb-multiarch /opt/symbols/controller_node |
set sysroot /opt/target-rootfs |
robot 是已经配置好的 SSH 主机别名;目标程序路径、参数和环境需要替换成实际值。SSH 连接依赖现有凭据和权限,本节不自动配置服务器,也不在实验容器中开放网络。
stdio 连接的被调试程序标准输入是 /dev/null,标准输出和错误输出通过管道返回;它不是透明的交互终端。需要从终端读取输入的程序,要另外设计输入方式,不能直接照搬这个无交互节点示例。
一个容易踩的坑:不能仅因为写了 gdbserver 127.0.0.1:2345 ... 就断言服务只绑定回环地址。GNU 手册明确说明其 host:port 形式中的 host 部分当前会被忽略。确实需要 TCP 时,应在受控网络命名空间中运行、限制端口可达性并检查实际监听地址;本地 SSH 转发端口也要限制在回环接口。SSH stdio 示例绕开了这一监听误区。GDBserver 官方说明与安全警告
远程机器上能跑,为什么本地看不懂
依次核对四项:目标 ISA 和 ABI、本地 GDB 的目标架构支持、同一次构建的符号、目标共享库。set architecture 不是 CPU 模拟器,不能把一个不支持目标架构的调试器变成完整跨平台工具。
对于 ARM 机器人上的 Linux 进程,通常选择匹配目标的交叉 GDB 或支持多架构的 GDB;对于裸机 MCU,连接方式和远程 stub 往往是 OpenOCD/J-Link 等,又是另一套目标约束。不要把 Linux gdbserver 示例直接当成飞控板裸机调试指南。
容器中出现 ptrace: Operation not permitted 时,也不要第一步就换成 --privileged。应先看是否调试自己的子进程、用户权限、PID 命名空间、seccomp 和 ptrace 策略;尽量缩小放开的能力与作用范围。
反向执行不是时光机
record full 需要事先记录
独立示例 reverse_demo.cpp 尽量只包含简单计算,减少记录器碰到复杂运行库路径的机会。在交互容器内编译后再运行:
g++ -g3 -O0 -fno-omit-frame-pointer \ |
先停在两个整数写入之前,然后只记录这段小程序;下面与本次会话中的操作相对应:
break reverse_begin |

本次在 ARM64 / GDB 12.1 中,第一次反向单步回到 reverse_end() 的调用位置,counter 仍为 2;第二次回到 counter = 2 尚未发生的状态,读到 1。这就是观察状态沿记录后退,而不仅是源码光标向上移动。
实测成功只针对 reverse_demo.cpp 这段受限的纯整数写入示例,不能推广为系统调用、SIMD、复杂多线程、rr 或硬件指令追踪也一定可用。迁移机器后先运行对应检查;若实际记录器报告不支持,就保留失败原因,不展示不存在的回放效果。
从 record full 之后的可记录范围,才有机会向后走。没有事先记录就发生的错误,不能靠事后输入 reverse-step 复原。回放时寄存器和内存状态来自执行记录,不是让外部世界真的倒着运行。GDB 记录与回放
实际限制包括 GDB 版本、CPU 指令、系统调用、记录大小和运行模式。遇到不支持的指令时,先缩小记录区域并阅读具体错误;不要把忽略未记录状态当成仍然精确的回放。record stop 会清掉该记录目标的执行日志,必要时先用支持的保存机制存档。
还要区分 record btrace:它偏重控制流轨迹,并不等同于完整数据历史。因此“能看到以前执行过哪段函数”不代表“能读取那一刻所有变量”。
rr 适合反复追同一个偶发现场
在受支持的 Linux、CPU 与权限配置上,rr 可以先记录一次,再多次回放这一次执行:
rr record ./my_program |
它的价值是把“每次重跑都不一定复现”变成“反复检查同一段执行”。回放时仍可以结合断点和反向执行分析,但 rr 是独立工具,不是任意 GDB 安装都自带的功能。
不要沿用“rr 只支持 x86”这种过时的绝对结论;当前项目列出了部分 AArch64 微架构支持。也不能据此承诺 Apple Silicon 上的 Docker Desktop 一定能跑:Linux 内核、性能计数器、虚拟化暴露和具体 CPU 支持都需要核对。本文没有声称已在当前实验环境执行 rr。rr 官方系统要求
对于连接真实设备的程序,回放里的“成功发送”不是让设备再执行一次同样的动作。涉及硬件和实时控制时,应先把可重放的软件边界与外部系统边界分清。
把诊断做成脚本
一次性现场采集
将下面内容保存为自己工程里的 capture.gdb:
set pagination off |
运行方式:
gdb --quiet --nx --batch \ |
这个脚本适合预期会因错误停住的程序;若程序正常退出,之后依赖活进程的命令可能报错。用于 CI 时应区分正常结束、信号终止、超时、GDB 自己失败四种结果,不要把“生成了日志文件”当成用例通过。
set logging file 只是选择文件,还需要显式启用记录。overwrite on 会覆盖同名日志,因此真实事故应使用独立的事件目录或不同文件名。旧版 GDB 的开关拼写可能不同,可先 help set logging 确认。GDB 日志输出
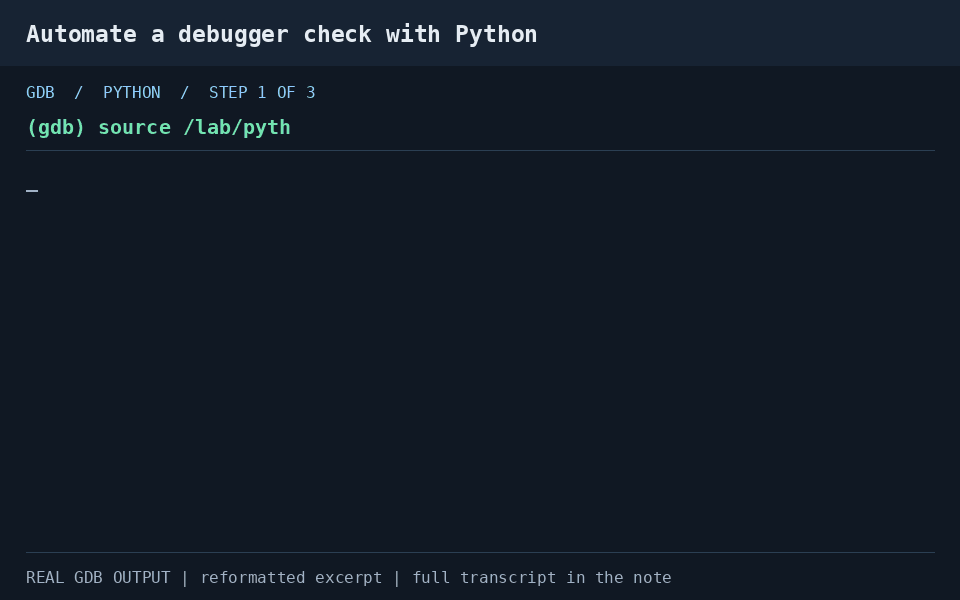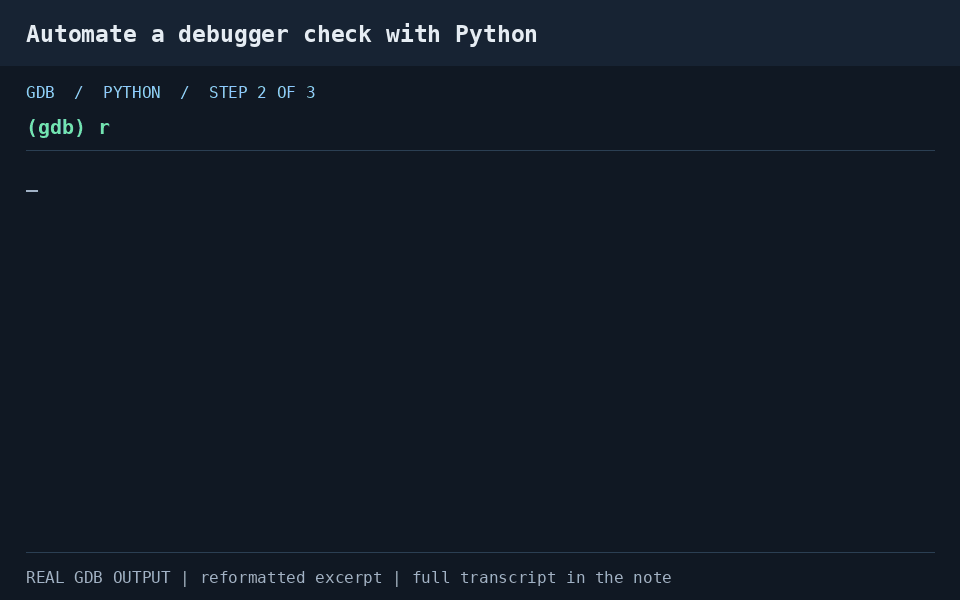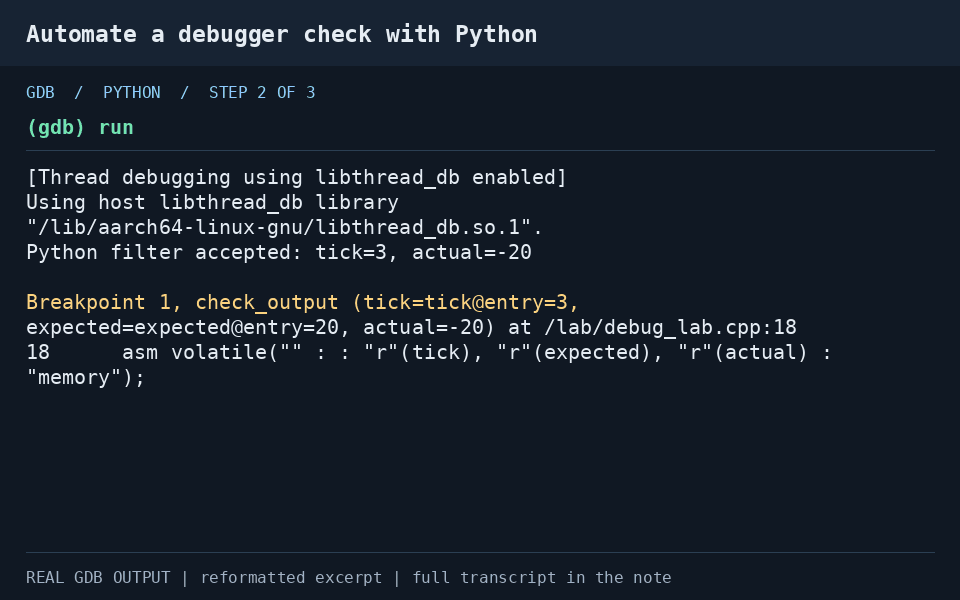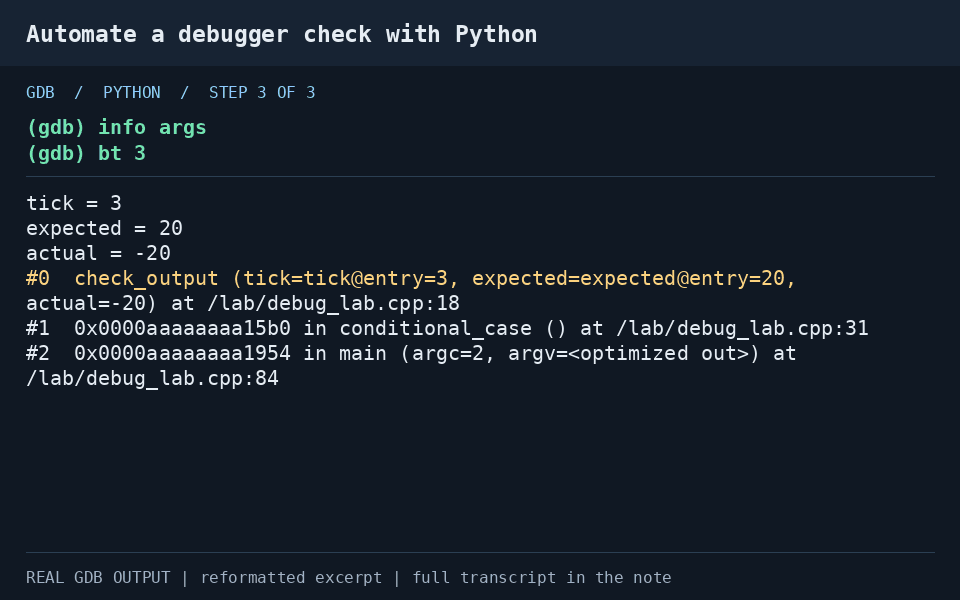
Python 断点:从条件表达式到业务规则
当筛选条件需要结构化逻辑时,可以让 GDB 执行 Python。以下是实验文件 python_breakpoint.py 所采用的机制:
import gdb |
在新的会话加载一次,然后运行:
gdb --quiet --nx --args /work/debug_lab conditional |
source /lab/python_breakpoint.py |

stop() 返回 True 才停住,返回 False 自动继续。这个回调应读取状态并决定是否停止,不应在回调里再执行 continue、切换执行状态或操作断点列表。简单条件本来就能表达时,优先用普通条件断点;Python 的价值在更复杂、可维护的诊断逻辑。GDB Python 断点 API
自定义一个快照命令
以下是可改造成工程脚本的模板,与上面的已录制 Python 过滤实验分开。保存为 snapshot.py,由 GDB 的 source 加载,不是用系统 python3 snapshot.py 运行:
import gdb |
gdb.Command 注册命令,invoke 是执行入口,dont_repeat 避免空回车意外重复。正式工程版还应处理无栈帧、目标退出、变量不可见、输出过大等情况。GDB Python 命令 API
工程上可以把“关节数量、输入维度、时间戳、模式、有效位”的检查封装为一个命令,但不要在打印器或断点回调里偷偷修正数据。先保证诊断是可解释的,再决定是否做可选的干预实验。
放到 ROS 2 工程里
用独立构建目录保留发布版本
以下示例面向 Ubuntu 22.04 / ROS 2 Humble 的普通 C++ 包,my_controller_pkg 和 controller_node 都要替换为自己的名称。这个实验镜像只负责 GDB 小程序,并不因此包含 ROS 2 工作空间。
source /opt/ros/humble/setup.bash |
独立目录让 Debug 产物不覆盖原来用于复现的发布构建。--packages-up-to 选择目标及其工作空间依赖,但不会给系统安装的二进制依赖凭空补出调试信息。colcon 构建目录选项、包选择规则
普通 CMake 工程可以使用:
cmake -S . -B build-debug \ |
CMAKE_BUILD_TYPE 用于单配置生成器;多配置生成器要在构建时选择 --config Debug。Debug、RelWithDebInfo 的实际编译选项仍应查看生成的编译命令,项目可能额外覆盖它们,不能只根据名字断言一定是 -O0 或一定有想要的符号。CMake 构建类型
调试 C++ 可执行文件,不是 ros2 脚本
ros2 run --prefix 'gdb -q --args' \ |
进入 GDB 后先设置断点,再 run。参数、命名空间、重映射、环境和 use_sim_time 要与出问题的启动方式一致。单独拿出一个节点但漏了参数文件,得到的可能是另一个问题。ROS 2 官方回溯指南源码
对于需要保持 launch 编排但只自动采集崩溃栈的情况,可给目标 Node 使用非交互 prefix;下面是独立模板,不直接当成一个可运行的完整 launch 文件:
from launch_ros.actions import Node |
交互调试更适合独立终端中的 ros2 run --prefix。launch 把输出放到屏幕上,不等于为每个子进程提供独立可交互终端;多个节点共享输出时,也很难看清属于谁的 GDB 提示符。
controller manager 和 Executor 怎么看
先找对进程。组合式节点可能共用 component container;一个进程也可能同时有控制循环、Executor、DDS 后台线程。暂停该进程往往会影响其中所有组件,不只是当前选中的 ROS 节点。
下面按 ros2_control 的读—更新—写循环和 ROS 2 回调调度机制,整理一套排查思路;它是诊断方法,不是某个尚未采集的真实故障结论。Controller Manager、ROS 2 Callback Groups 官方源码
读取栈时,可以按工作角色判断:
- 停在硬件
read():检查驱动等待、I/O 超时、设备返回以及时间戳。 - 停在控制器
update():检查输入状态、周期、索引和矩阵尺寸是否满足前置条件。 - 停在
write():检查限幅、模式切换以及发往硬件的命令。 - 停在 Executor 等待路径:可能是正常空闲,也可能是任务没有被唤醒,需要结合回调和业务条件。
- 回调里同步等待另一个回调:进一步检查 callback group、Executor 可用线程和锁关系,不要只看到 MultiThreadedExecutor 就认为不可能互等。
GDB 可以检查当时的调用链,但它不是实时性评估工具。单步得到的循环耗时没有正常运行意义;评估控制周期抖动、回调延迟,应在不被断点频繁中断的运行中使用 tracing、统计或性能工具。
对动态加载的控制器,可以先设置 pending 断点,待库加载后用 info sharedlibrary、info breakpoints 确认。断点一直没命中时,同时检查控制器生命周期和实际执行路径,不能只检查符号。
TUI、cgdb 与检测工具
TUI:把源码、汇编和命令放在一起
gdb -tui --args /work/debug_lab conditional |
start |
Ctrl-x 再 a 切换 TUI,Ctrl-x 再 o 切换窗口焦点,Ctrl-l 刷新屏幕。方向键可能在滚动当前窗口而不是浏览命令历史,此时先把焦点放回命令窗口。优化代码对应关系不清楚时,源码与汇编并排比一直按 next 更有帮助。GDB TUI 按键
cgdb:保留原来的终端习惯
原笔记在 2025.10.9 记录过 cgdb。它给 GDB 配上便于浏览源码的终端界面,核心断点、观察点和栈命令仍然属于 GDB,不是一套不同的调试语义。
如果使用自己的 Ubuntu 开发环境,可通过发行版安装 cgdb;本文基础实验镜像是否包含它,以镜像文档为准,GIF 不代表已经验证交互界面:
sudo apt-get install cgdb |
进入 GDB 命令窗口后,使用同一个实验模式:
set args conditional |
源码窗口中可用类似 Vim 的移动和搜索;Esc 回到源码窗口,i 回到 GDB 命令窗口。常用操作是先在源码区定位,再切到 GDB 输入 break、run、print。不要把“当前浏览的源码行”和“当前程序执行位置”混为一谈。CGDB 官方手册
IDE、GUI 或 TUI 可以减少窗口切换,但当变量显示不出来时,仍应回到符号、作用域、优化和生命周期这些基本问题。换一个更漂亮的前端不会自动补回丢失的现场。
GDB 和检测工具各自负责什么
GDB 适合检查一个具体现场、控制执行并验证假设;ASan 擅长检测某些内存访问错误,TSan 用于数据竞争,Valgrind Memcheck 检查内存使用问题。它们互补,并非谁能替代全部其他工具。
在自己工程的隔离测试构建中,可分别建立 Sanitizer 版本:
# 内存/部分未定义行为检查构建 |
编译和最终链接都要带对应检测选项;ASan 与 TSan 不能合并成一个所谓“全能开关”。检测器同样会改变时间和内存行为,没报告也不是程序绝对安全的证明。GCC 检测插桩选项
本文的余额误写是合法地址上的错误业务值,ASan 未必会报错,这正是业务约束加观察点有价值的地方。数据竞争也不宜只靠断点抓:暂停和恢复可能把竞态窗口改变掉。
Valgrind 与 GDB 可以连接使用。下面是另一个环境中的模板,不属于当前小实验的运行结果:
# 终端一:先等待调试器连接 |
target remote | vgdb |
多个 Valgrind 进程同时运行时,需要根据其提示选择正确 PID。--vgdb-error=0 用于启动时等待;若希望在检测错误后停止,再按相应阈值配置。Memcheck 报告可帮助定位无效访问,GDB 再用于检查上下文。Valgrind 与 GDB 集成
检测工具会带来开销,不能拿开启 Memcheck 的控制循环耗时直接评估实时性能;也不应把这些故意出错的实验放到连接动力系统的实机上。
自己完成一个排查闭环
三个练习
第一个练习:把 conditional 模式中错误出现的时刻从 tick == 3 改到另一个值,但不要改 GDB 的条件表达式。重新构建,确认断点仍能找到“实际值不等于期望值”,说明诊断依赖的是约束而不是记住某次循环编号。
第二个练习:给余额再加一次合法入账,然后只在余额变成负数时停住。先比较无条件观察点与附加条件的行为,再检查如果某处写入相同值,会不会符合你对 watch 的预期。
第三个练习:在源码副本里让线程实验正确发布结束条件并通知 worker,重新运行确认可以退出。要在持有对应互斥锁时改变条件,配合正确的通知,而不是在 GDB 里随便改一个布尔量就宣布修复了并发问题。
练习修改应该写入自己的源码副本,不需要放开本文只读挂载。不要直接改动已经记录过的实验源码却仍拿旧日志声称验证有效。
一份能交给未来自己的调试记录
- 问题:哪条业务约束被破坏,预期值与实际值是什么?
- 环境:代码提交、镜像或系统、目标架构、编译器、GDB、构建选项。
- 入口:完整启动参数、环境、参数文件、输入数据和复现概率。
- 证据:停止原因、线程、业务栈帧、关键参数、观察点或检测器输出。
- 推理:为什么这份证据支持当前原因,哪些替代解释还未排除?
- 干预:是否修改过变量、信号策略、线程调度或环境;这些修改会影响什么?
- 修复:源码改了什么,原始复现和相邻边界用例是否都通过?
- 遗留:未测试的平台、远程权限、硬件、运行库与符号是否还缺失?
最终目标不是收集更多命令,而是让每条命令都有一个要回答的问题。能从“结果不对”追到“第一次错误状态”,从“线程卡住”追到“等待条件无法成立”,再把这个过程保存成可复现材料,GDB 才真正成为工程工具。